
منصة AI-Docu-Mind: محرك الذكاء الوثائقي والبحث الدلالي RAG المحلي الحافظ للخصوصية
منظومة ذكاء وثائقي مؤسسية مبنية بتقنيات RAG المتقدمة لحفظ سرية المستندات، تجمع بين استيعاب مختلف صيغ الملفات، والبحث الهجين فائق الدقة (Dense + BM25)، وتوليد إجابات موثقة باقتباسات حرفية مع دعم كامل للتشغيل المحلي المعزول عبر Ollama.
ليه استخدام الذكاء الاصطناعي التقليدي مع المستندات والعقود بيمثل مخاطرة كبيرة؟
الشركات والمكاتب القانونية والهندسية بيكون عندها آلاف العقود والمواصفات الفنية وتقارير الـ PDF اللي بتمثل قلب شغلها وأسرارها التجارية. ولما بيحاولوا يعتمدوا على روبوتات الذكاء الاصطناعي العامة للإجابة على استفسارات العقود، بيصطدموا بثلاث مشاكل جوهرية:
المشكلة الأولى هي الهلوسة؛ النماذج اللغوية ممكن تولد إجابات تبدو مقنعة جداً وبلغة بليغة، لكنها تفتقر لأي أساس في العقد الحقيقي، وده في مجالات زي العقود أو الحسابات الهندسية ممكن يسبب كوارث قانونية وخسائر فادحة. المشكلة التانية هي سرية البيانات؛ جهات كتير مستحيل تقبل برفع وثائق المناقصات أو العقود على سيرفرات سحابية خارجية في أمريكا عبر واجهات الـ API. والمشكلة التالتة تقنية بحتة: البحث المتجهي العادي (Semantic Embeddings) لوحده بيفشل في لقط الأرقام الدقيقة أو أكواد المواد وبنود العقود المختصرة، لأنه بيدور على التقارب المعنوي مش الكلمة الحرفية.
عشان أحل المشاكل دي، صممت AI-Docu-Mind كمنظومة استرجاع معزز بالتوليد (RAG) مؤسسية هجينة تضمن أعلى درجات الدقة مع بقاء كل الوثائق داخل حدود سيرفراتك.
المعمارية الهجينة: استيعاب الصيغ والبحث المزدوج فائق الدقة
بنيت خط معالجة واسترجاع للمستندات متماسك يمر بعدة مراحل هندسية واضحة:
المحرك بيتعامل مباشرة مع مختلف صيغ الملفات (PDF، Word، جداول CSV، ملفات Markdown و JSON). بيستخرج النصوص والبيانات الوصفية، ويولد بصمة تجزئة SHA-256 لكل ملف عشان يمنع التكرار ويوفر فهرسة ذرية في قاعدة البيانات.
بعدها بتبدأ مرحلة التقطيع التكراري الذكي (Recursive Chunking) بنافذة متداخلة تحافظ على سياق الجمل ومعاني الفقرات بين الصفحات، وتمنع بتر النصوص في مواضع حرجة قبل تحويلها إلى متجهات دلالية.
ولحل مشكلة ضياع الأرقام والكلمات المفتاحية، طوّرت خط استرجاع هجين (Hybrid Search) يجمع بين البحث الدلالي الكثيف عبر مكتبات SentenceTransformers وقاعدة ChromaDB لفهم المعنى العام، وبين البحث المعجمي الدقيق بخوارزمية BM25. النتيجة إن المنظومة بتفهم السؤال دلالياً، وفي نفس الوقت متفوتش أي رقم بند تعاقدي أو كود مالي دقيق.
حواجز مكافحة الهلوسة والربط بالنماذج المحلية والسحابية
صممت طبقة التوليد لتخضع لقواعد صارمة تمنع الموديل من تأليف أي معلومات خارج سياق الوثيقة:
واجهة تفاعلية وأدوات سريعة للمطورين
المنظومة بتقدم تجربة استخدام مرنة صممت لتناسب المحللين وفرق التطوير:
واجهة مستخدم حديثة تتيح سحب وإفلات المستندات، واستعراض إحصائيات الفهرسة، والدردشة مع الوثائق مع بطاقات مراجع تفاعلية؛ بمجرد ما تدوس على كارت المصدر بتفتح لك الفقرة الأصلية المظللة في صفحة الـ PDF مباشرة عشان تتأكد بنفسك.
كمان وفرت واجهة سطر أوامر (CLI) مدعومة بمكتبات Typer و Rich بتسمح للمهندسين بفهرسة فولدرات المستندات الضخمة ومراقبة صحة النظام من التيرمينال، مع واجهات برمجية REST كاملة بـ FastAPI وحاويات Docker جاهزة للنشر السريع في البنية التحتية للمؤسسة.
انقر على أي شاشة للدخول إلى الاستوديو التفاعلي وتكبير المخططات بدقة فائقة وفحص التفاصيل (Zoom In / Out).
 01
مساحة العمل واسترجاع الإجابات الموثقة
شات تفاعلي مباشر مع المستندات يعرض الإجابة لحظياً مع بطاقات مصادر واقتباسات قابلة للنقر تكشف الفقرة الأصلية في ملف الـ PDF.
 02
واجهات برمجة التطبيقات والتوثيق التفاعلي
واجهات برمجية عالية الأداء لرفع المستندات، وإدارة فهارس المتجهات، والاستعلام اللحظي ودمج المنصة مع أنظمة الشركات.
هل يعجبك هذا النوع من المشاريع؟
يمكننا تنفيذ مشروع مماثل ومخصص لمتطلبات عملك.
مشاريع أخرى قد تهمك
أنظمة حية، حلول ذكاء اصطناعي، وبنية تحتية برمجية متكاملة.
 أنظمة ERP وإدارة الأعمال
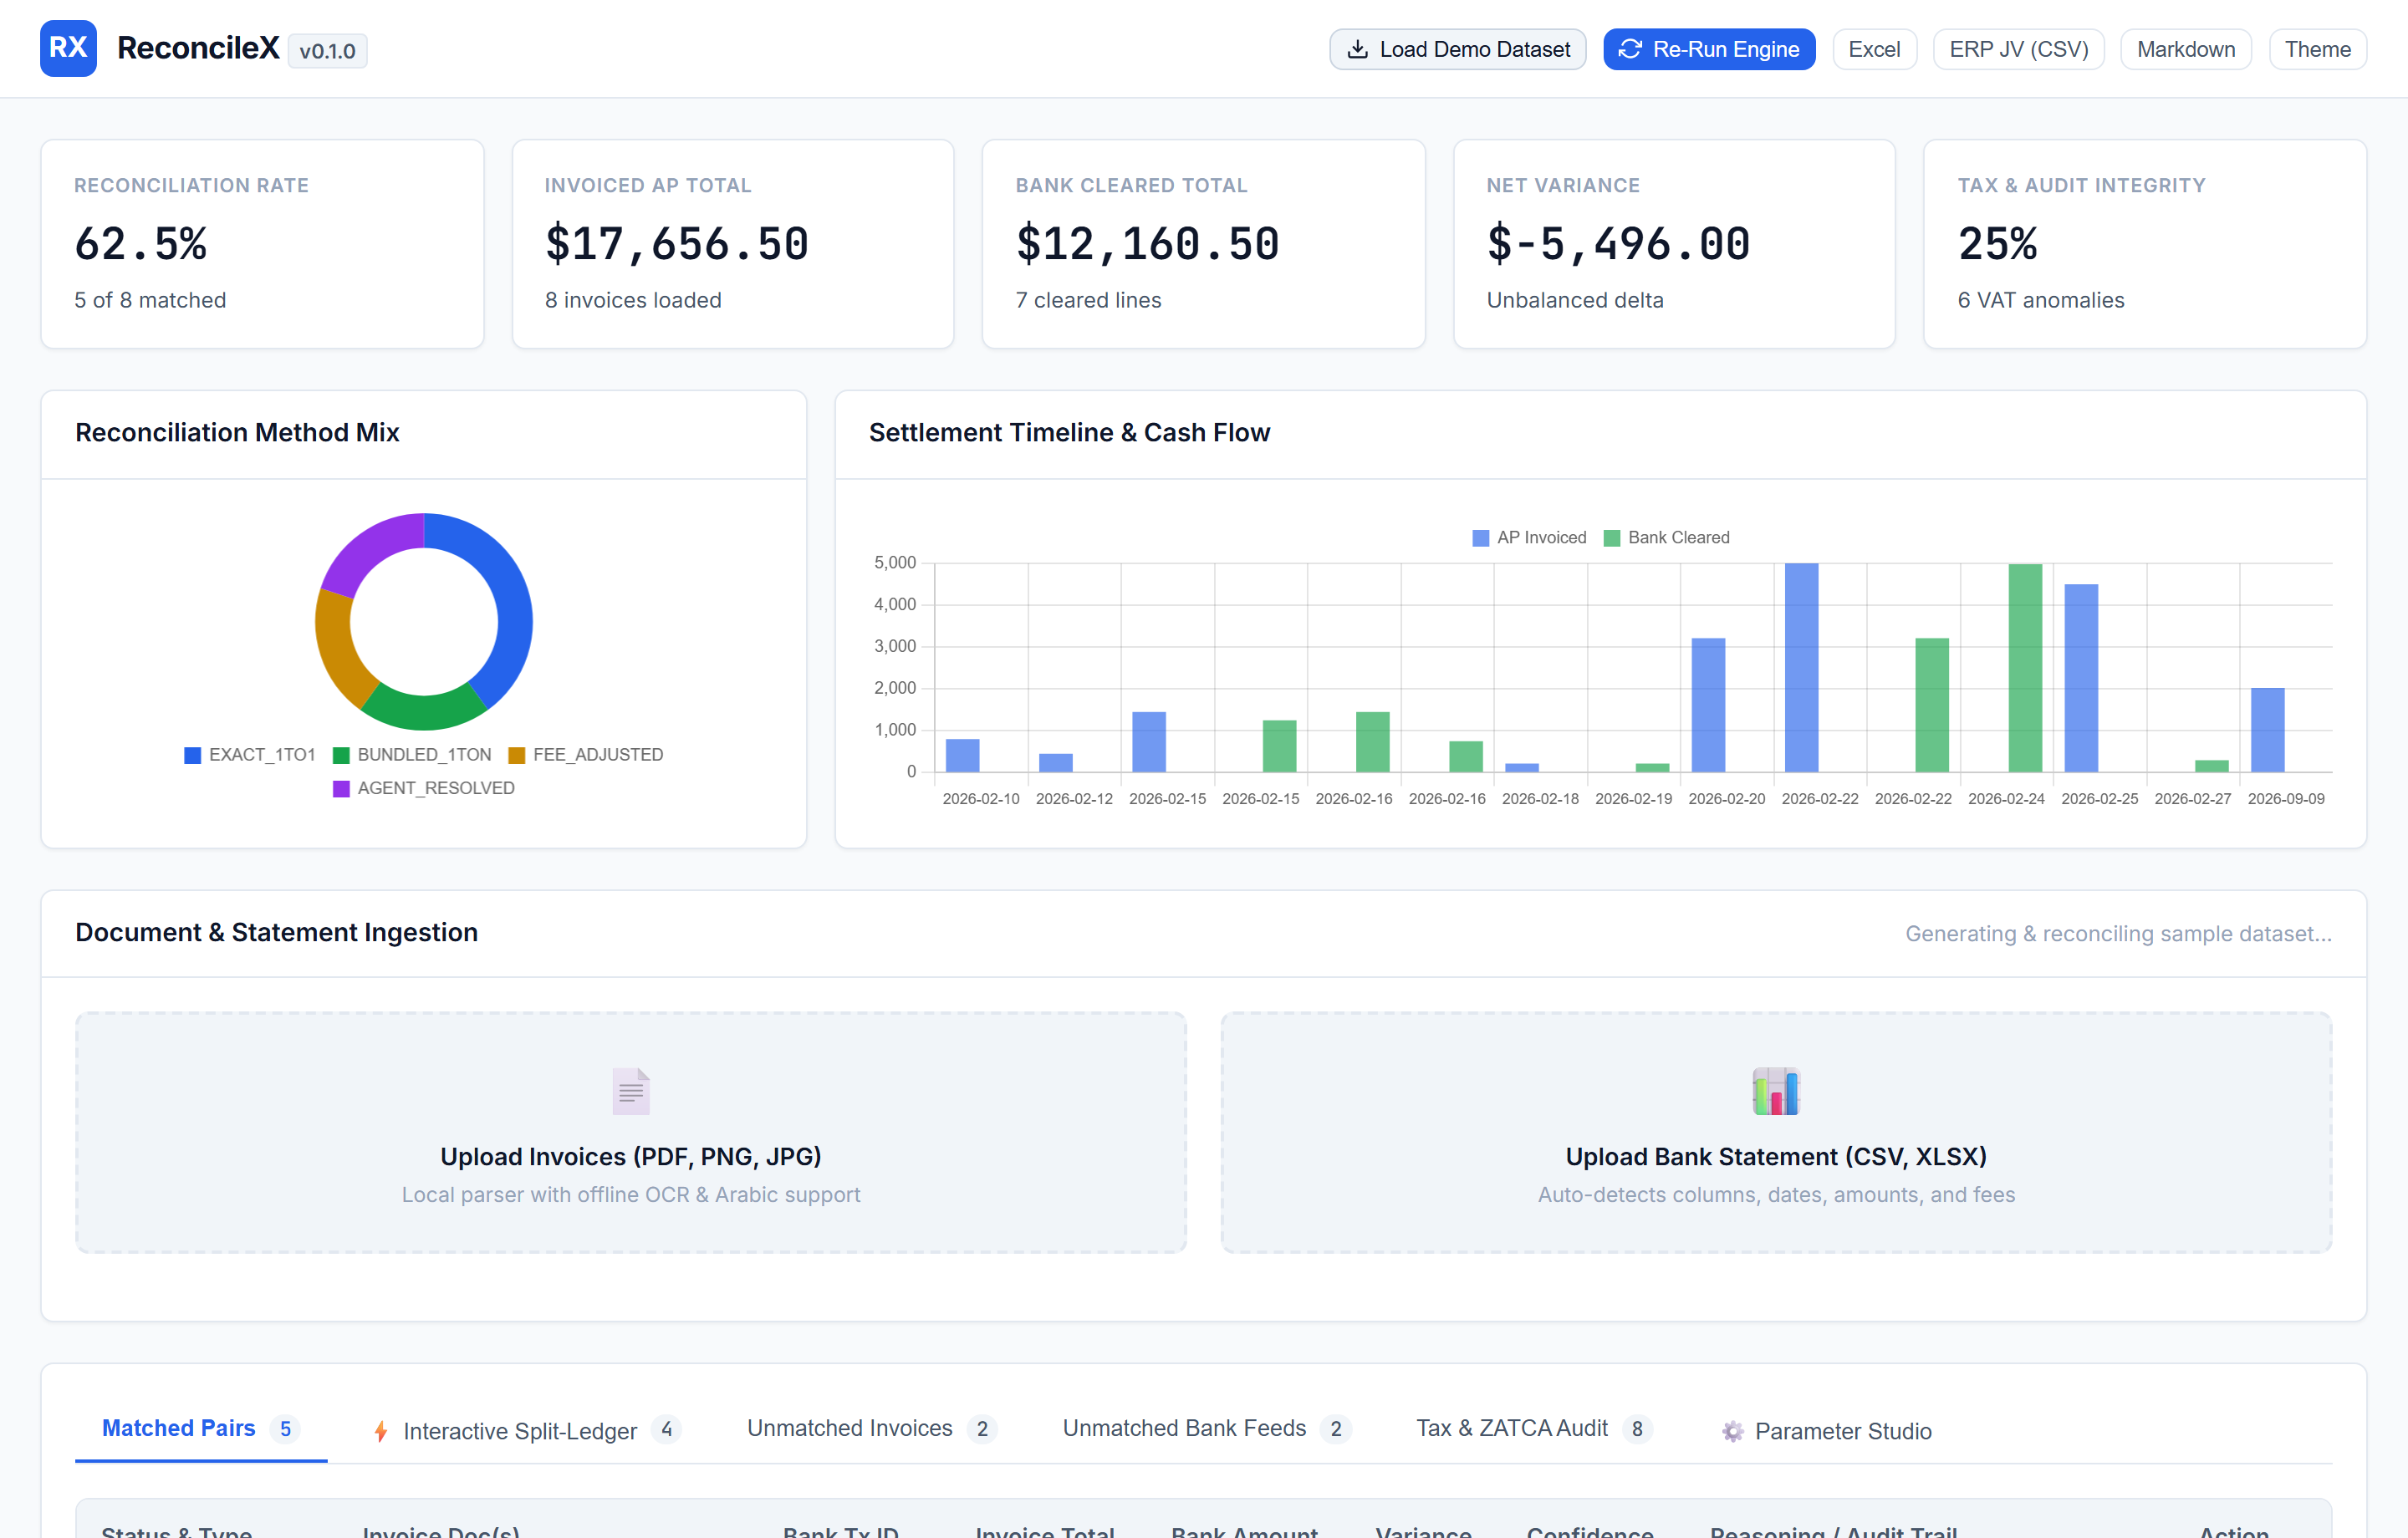
منصة ReconcileX: محرك التسويات المالية المؤسسية والامتثال الضريبي لـ ZATCA
محرك تسوية مالية مؤسسي مفتوح المصدر ينهي المطابقة اليدوية في جداول الإكسيل، يدمج المعالجة الحسابية الحتمية الخالية من الهلوسة مع الذكاء الاصطناعي الدلالي لمعالجة المدفوعات المجمعة، وفحص امتثال ضريبة القيمة المضافة لـ ZATCA، وتوليد قيود يومية متزنة للـ ERP.
 أدوات ومحركات سحابية
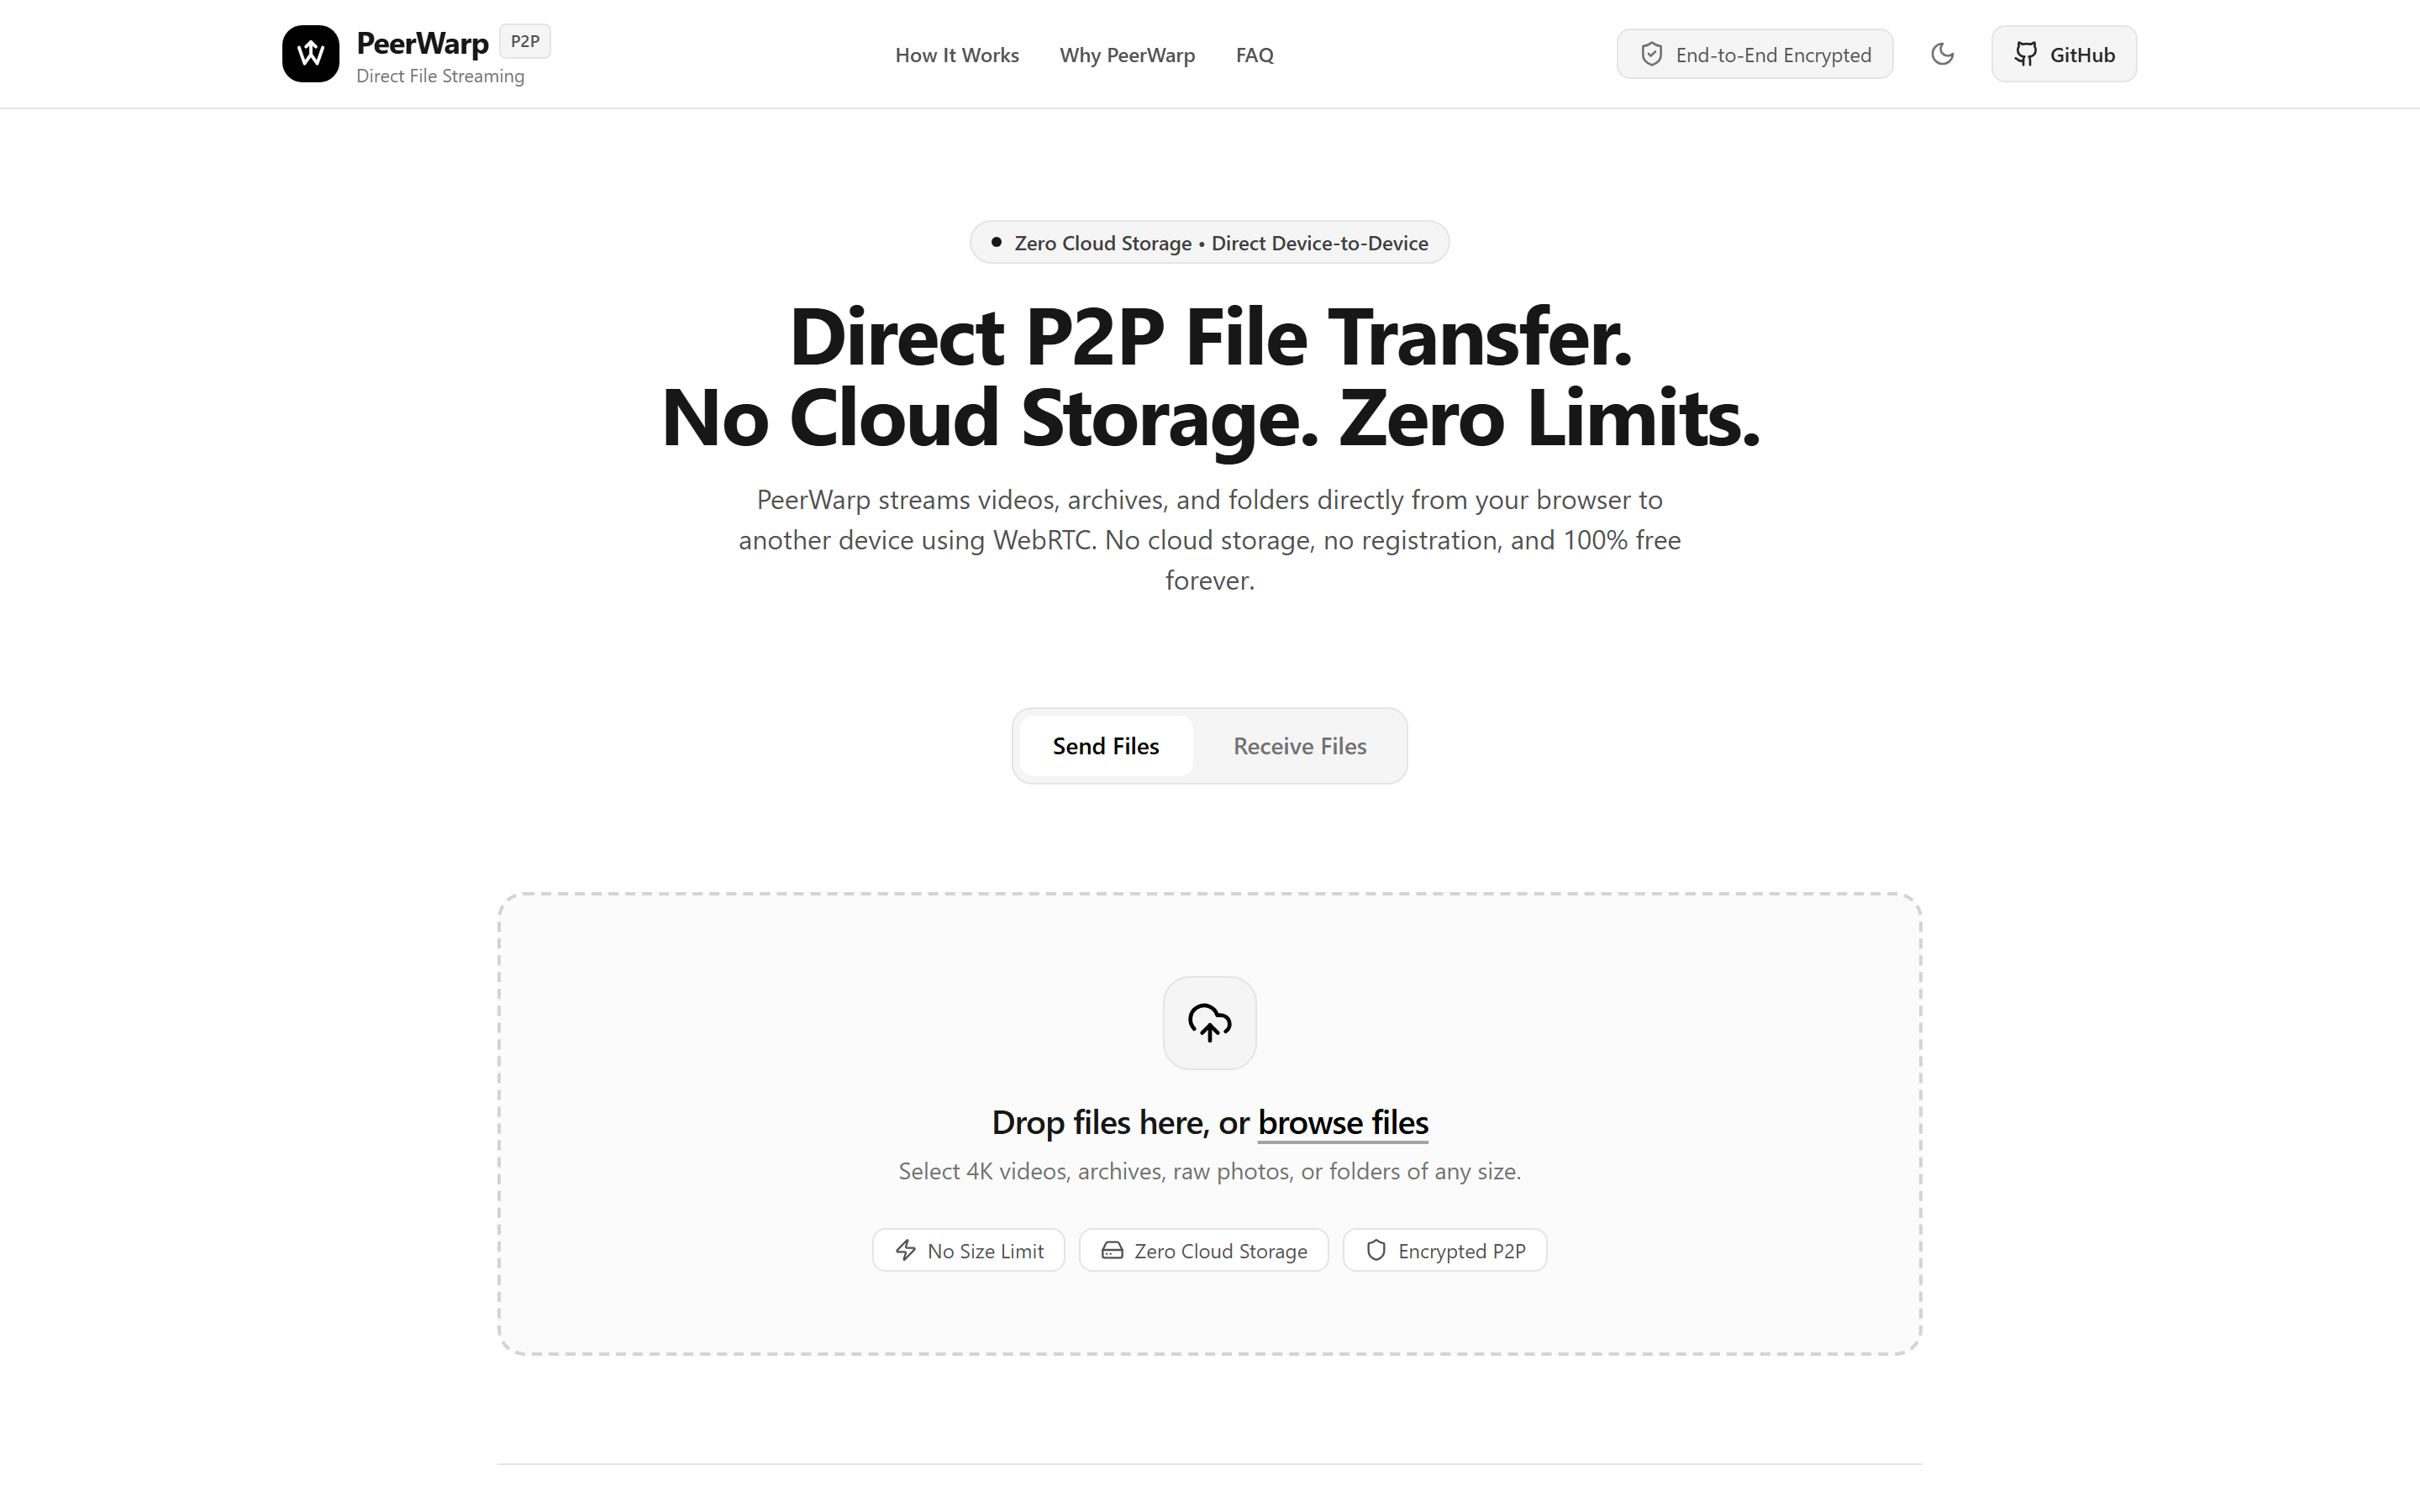
منصة PeerWarp: نقل ومشاركة الملفات الضخمة مباشرة بين الأجهزة والمتصفحات دون وسيط سحابي
منصة ويب مفتوحة المصدر لنقل الملفات والفولدرات الضخمة بين الأجهزة والمتصفحات مباشرة عبر تقنية WebRTC دون الحاجة لرفعها على أي سيرفر سحابي وسيط، تدعم الكتابة المباشرة على الهارد ديسك لتفادي امتلاء الرامات وتهنيج المتصفح، مع ميزة الضغط التلقائي للملفات ورادار لاكتشاف الأجهزة المتصلة على نفس شبكة الواي فاي.
 ذكاء اصطناعي وأتمتة
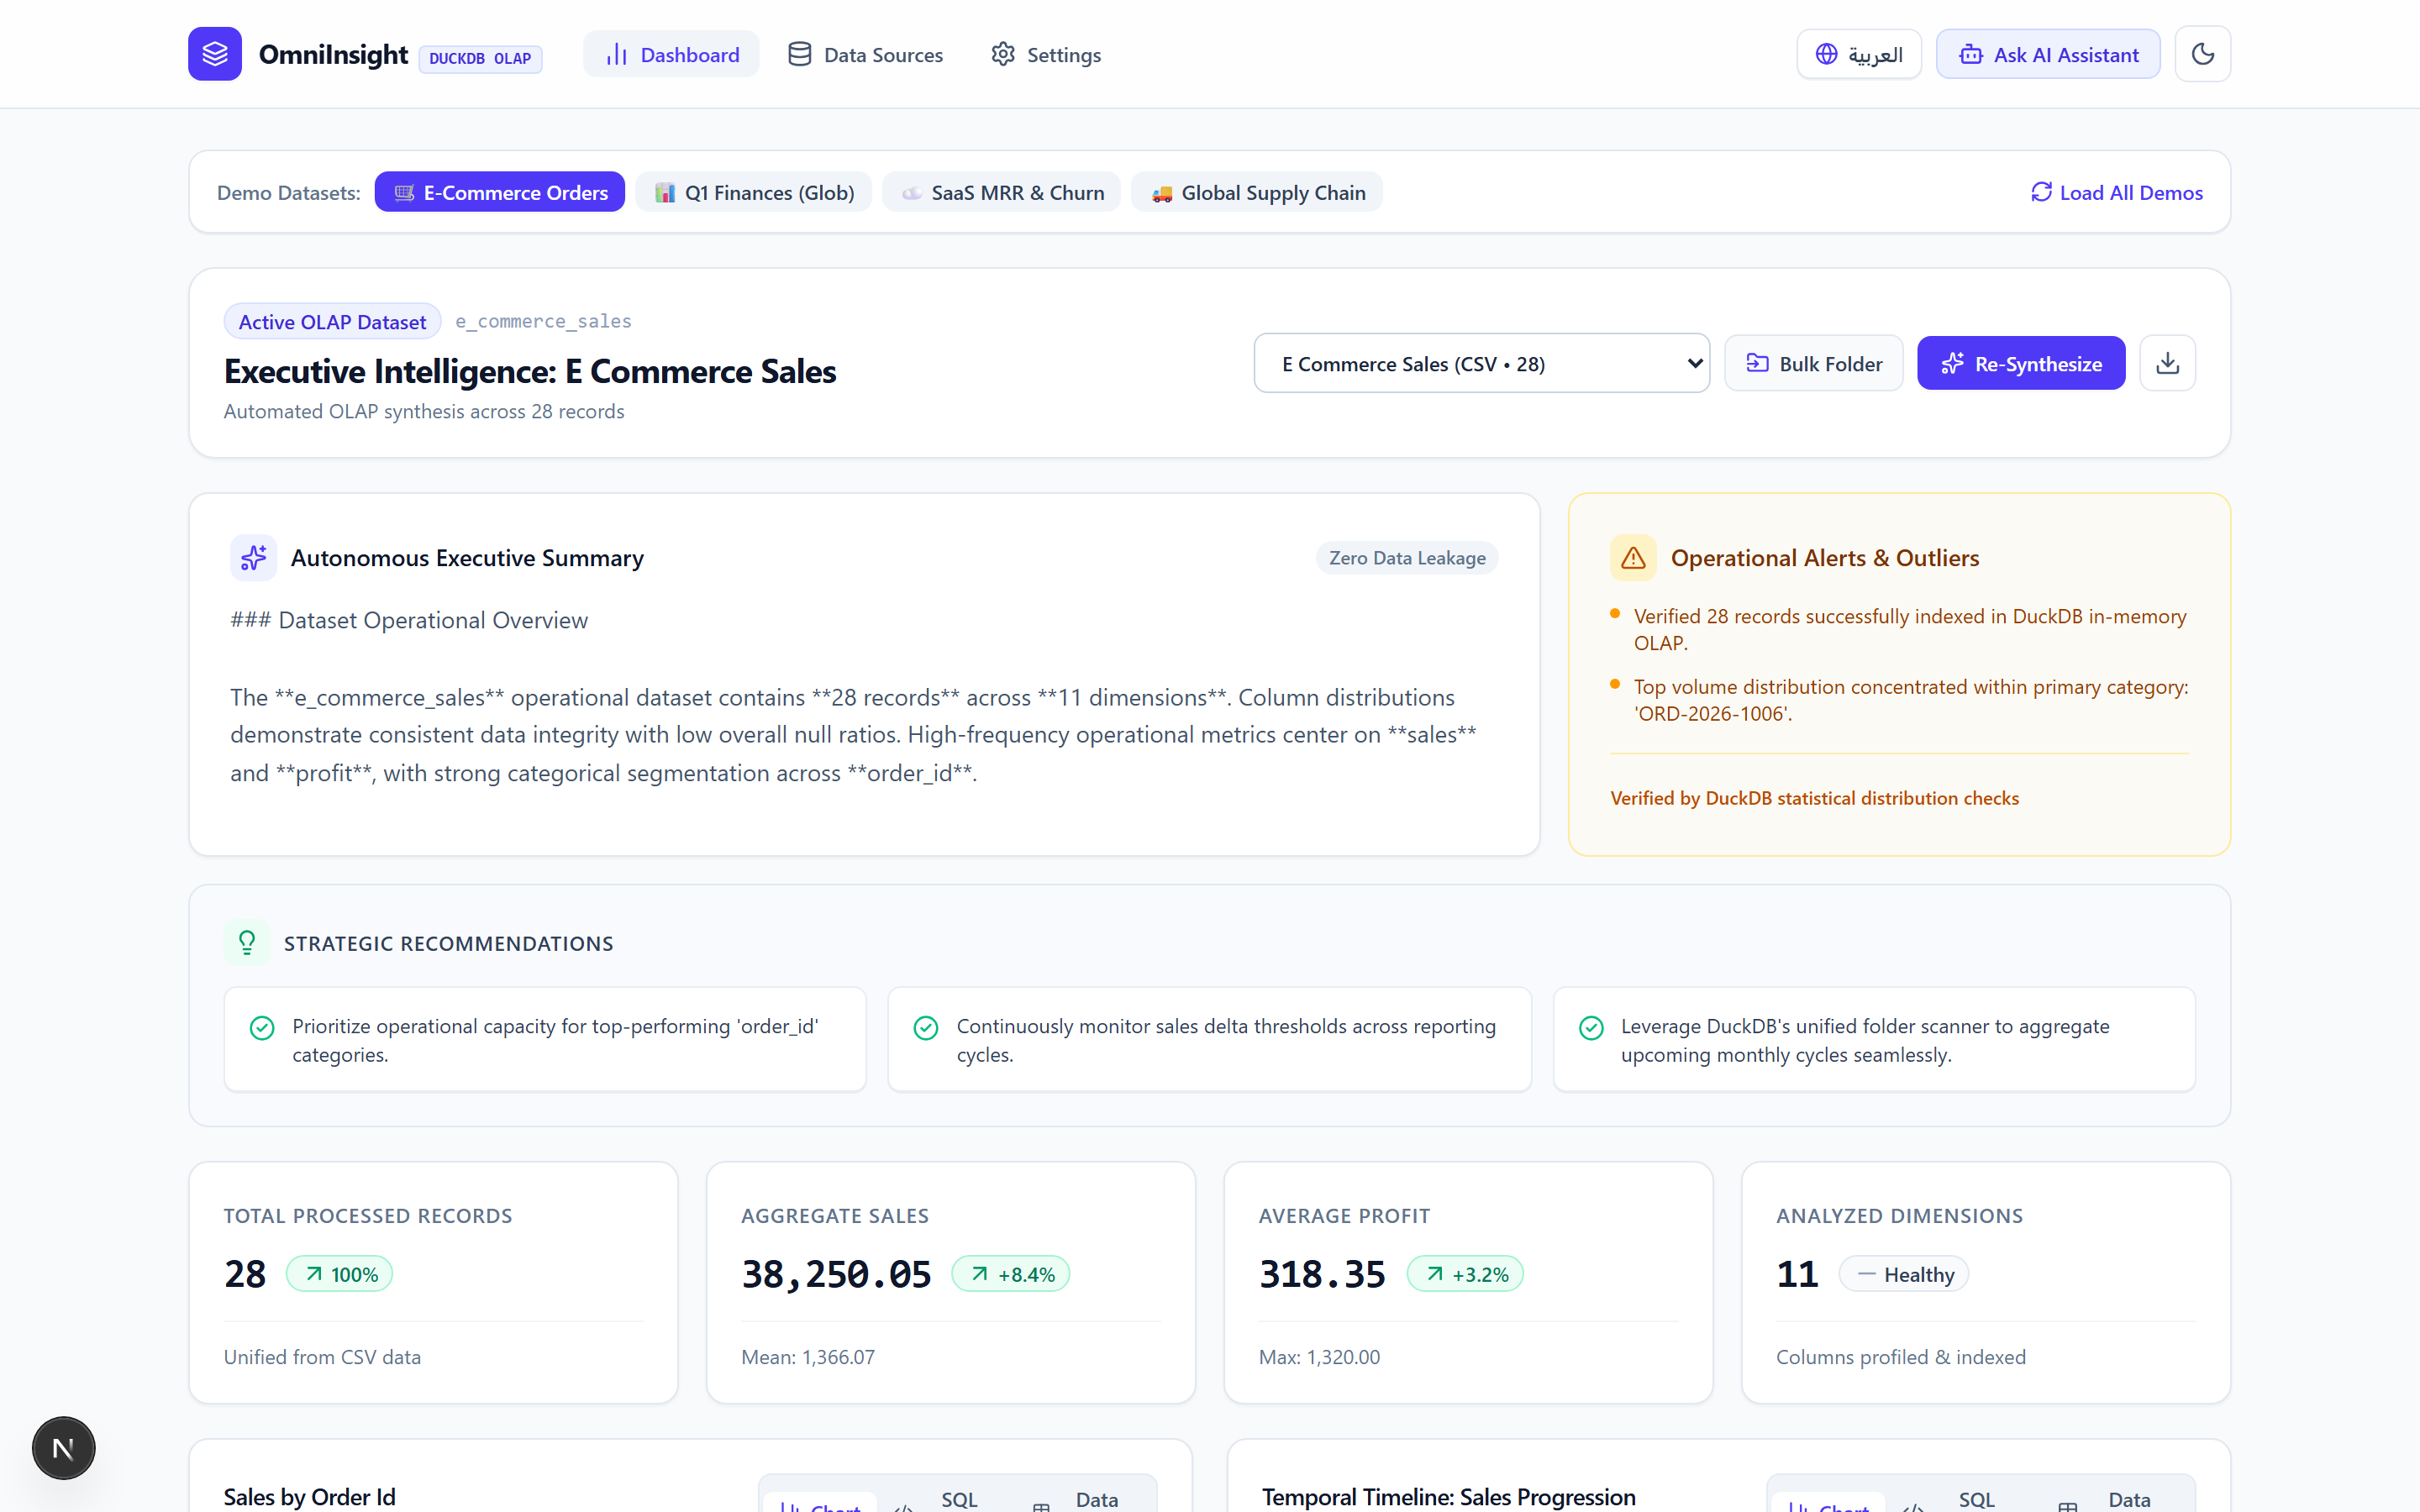
منصة OmniInsight: ذكاء الأعمال المحلي والتحليل الآلي بـ DuckDB والذكاء الاصطناعي الحافظ للخصوصية
منصة ذكاء أعمال محلية ومفتوحة المصدر تنهي تكاليف تراخيص البرمجيات السحابية الباهظة، تجمع بين سرعة محرك DuckDB المدمج في معالجة ملايين السجلات في الرامات، وطبقة ذكاء اصطناعي عبر LiteLLM لتوليد لوحات تحكم واستعلامات بلغة طبيعية مع ضمان بقاء البيانات الحساسة بالكامل داخل سيرفراتك.